
Lolly conserva la tua libreria personale sul dispositivo. Un bundle di backup è il modo in cui quella libreria si sposta: esportalo su un'installazione, porta il file come preferisci (USB, AirDrop, email a te stesso o una condivisione di rete) e importalo su un'altra. Esportare e importare non richiedono alcun server, e la destinazione può essere offline.
Questa pagina è la specifica del formato, per chi costruisce shell, strumenti o script attorno ai backup: cosa c'è nello zip, come vengono controllate le versioni, come si fonde un'importazione e cosa viene verificato. La guida per chi sposta il proprio lavoro è Move your work to another device.
 signed by Lollyvector SVG9 paths~4.9k nodes11 groups56 KBCheck it yourselfScarica il file firmato
 signed by Lollyvector SVG9 paths~4.9k nodes11 groups56 KBCheck it yourselfScarica il file firmato
Ambito. Un bundle porta dati dell'utente, non strumenti del catalogo. Gli strumenti e le risorse del catalogo vengono sincronizzati separatamente e si presume siano già presenti sulla destinazione, al limite a una versione più alta. Gli strumenti che un utente ha creato da sé viaggiano dentro
profile.json. L'importazione non installa né aggiorna mai uno strumento del catalogo.
Obiettivi
- Un formato, ogni shell. L'app web, le app desktop e mobile e le shell future condividono lo stesso envelope e gli stessi schemi delle parti. Le parti facoltative dipendono dalle capacità di ciascuna shell, e le parti non supportate vengono segnalate. Ogni bridge di capacità fornisce il proprio adattatore di archiviazione.
- Sopravvive al viaggio. Un bundle danneggiato o troncato durante il trasferimento fallisce in modo evidente all'importazione e non si ripristina mai a metà.
- Sopravvive a questa versione. Un'app più vecchia può comunque importare le parti riconosciute di un bundle più recente. Un formato davvero incompatibile viene rifiutato in modo netto.
- Sicuro da unire. Importare su un'installazione già in uso non cancella mai nulla che non fosse nel bundle.
La busta
Un bundle è un normale .zip, quindi sopravvive intatto a qualsiasi trasporto e qualsiasi strumento di decompressione può ispezionarne il contenuto.
Il download prende il nome della persona a cui appartiene: LollyTools-<First>-<Last>-<YYYY-MM-DD>-<n>.zip, per esempio LollyTools-Ada-Lovelace-2026-06-26-1.zip, così una cartella Download di backup resta leggibile. Nome e cognome vengono dal profilo e sono omessi se non impostati: nessun profilo dà LollyTools-2026-06-26-1.zip, e il solo nome dà LollyTools-Ada-2026-06-26-1.zip. Ogni nome viene ridotto a un token sicuro per i nomi di file (lettere e cifre Unicode mantenute, spazi e punteggiatura eliminati, al massimo 32 caratteri). <n> è una sequenza per giorno e per dispositivo, quindi esportazioni ripetute nello stesso giorno non collidono e restano in ordine. backupFilename() in data-transfer.ts costruisce il nome, e il contenuto dello zip è lo stesso qualunque sia il suo nome.
| Percorso | Obbligatorio | Contenuto |
|---|---|---|
manifest.json | sì | Id del formato, versioni, conteggi e integrità per parte. La prima cosa che un lettore guarda. |
profile.json | quando impostato | L'intero record me dell'utente: nome, contatti, riferimento alla foto e flag, più cartelle, Cestino, modelli di progetto, template dell'utente e strumenti creati dall'utente, preferiti, strumenti nascosti, lingua e scelta delle emoji. Letto tramite host.profile. |
sessions.json | sì | Ogni sessione salvata: slot, id e versione dello strumento, etichetta, miniatura (data URL) e dati di input completi. Letto tramite host.state. |
assets.json | sì | Metadati di ogni risorsa caricata (immagini, font, token del brand, loghi, copie salvate dei download), ciascuno rivolto ai propri byte sotto assets/blobs/. |
assets/blobs/<n>.<ext> | per risorsa | I byte grezzi della risorsa, memorizzati non compressi perché la maggior parte è già in formati compressi. L'estensione è cosmetica; il tipo MIME in assets.json è quello autorevole. |
assets/blobs/<n>.c2pa | quando presente | Content Credentials estratte come byte binari esatti, referenziati da _credentialFile nel record della risorsa. Non sono chiavi di firma del dispositivo. |
design-systems.json | quando presente | I design system creati o aggiunti su questa installazione, come { active, records }. Vedi Regole di importazione. |
file-history.json | facoltativo | Istantanee versionate delle risorse, report delle operazioni sui file concluse e manifest completi dei batch, con una versione propria. Fornito dall'adattatore di backup interno fileHistory della shell. |
revision-history.json | facoltativo, backup manuali | ID di creazione stabili, checkpoint conservati, miniature e bozze di ripristino a rotazione. Fornito da host.state.history.backup dove supportato. |
file-history/versions/ | per istantanea | Byte precedenti delle risorse ed estratti delle credenziali, che la risorsa corrente esista ancora o meno. |
file-history/results/ | per operazione conclusa | Byte esatti dell'output. Nessun file originale selezionato per la conversione viene conservato né incluso. |
prefs.json | sì | Preferenze locali dell'utente: theme, sidebarWidth e il conteggio di attività ct-metrics. |
lolly.txt | sì | Un riepilogo leggibile del bundle (conteggi, profilo, nome file) per chiunque apra lo zip senza Lolly. Rigenerato a ogni esportazione e riconosciuto all'importazione, quindi non conta mai come parte saltata. Viene scritto dopo la mappa di integrità, quindi la mappa non copre questo file. |
Come l'esportazione scrive lo zip
L'esportazione scrive lo zip una parte alla volta (shells/web/src/lib/zip-stream.ts). I caricamenti, i risultati salvati e le versioni salvate delle risorse vengono letti a blocchi da 4 MiB, mai interi, e i risultati e le versioni salvati vengono prima controllati rispetto al loro SHA-256 registrato. Ogni file viene poi letto per il suo checksum e digest di integrità, e lo zip vi fa riferimento dove si trova.
Nulla viene ricodificato, quindi un file che porta Content Credentials mantiene i byte esatti coperti dalla sua firma, e ogni parte mantiene i suoi byte e il suo digest esatti. Per le stesse parti e lo stesso momento lo zip è identico a quello del precedente writer in memoria, tranne che un file di cronologia oltre 16 MiB viene compresso a pezzi. tests/backup-streaming.test.ts lo verifica rispetto a digest di riferimento registrati.
Su una libreria sintetica da 192 MiB, misurato in Node, completare il backup ha richiesto circa 125-150 MiB oltre alla libreria, contro circa 850 MiB per il writer in memoria (node scripts/bench-backup-finalise.ts). L'importazione legge ancora l'intero zip in memoria.
manifest.json
{
  "format": "lolly-backup",
  "formatVersion": 3,
  "minReader": 1,
  "app": "lolly",
  "exportedAt": "2026-06-22T09:30:00.000Z",
  "counts": { "profile": true, "sessions": 2, "userAssets": 4, "prefs": 3, "assetVersions": 1, "fileOperations": 1 },
  "integrity": {
    "profile.json": "sha256-…",
    "sessions.json": "sha256-…",
    "assets.json": "sha256-…",
    "assets/blobs/0.bin": "sha256-…",
    "file-history.json": "sha256-…",
    "file-history/versions/0.bin": "sha256-…",
    "file-history/results/0.bin": "sha256-…",
    "prefs.json": "sha256-…"
  }
}| Campo | Significato |
|---|---|
format | Sempre lolly-backup. Un file che non lo ha viene rifiutato come "not a Lolly backup". |
formatVersion | Il layout con cui questo bundle è stato scritto. Incrementato a ogni modifica dell'insieme delle parti o delle loro forme. I lettori non si basano su questo campo. |
minReader | La versione minima del lettore che può importare questo bundle in sicurezza. È il campo su cui si basano i lettori. |
app | Id dell'app produttrice, per la diagnostica. |
exportedAt | Timestamp ISO di creazione del bundle. |
counts | Ciò che il writer ha inserito, per la visualizzazione e i controlli di coerenza. |
integrity | Facoltativo. Associa ogni parte tranne manifest.json a un digest sha256-<base64> in stile SRI dei suoi byte non compressi. |
Politica delle versioni
Due numeri di versione permettono al formato di crescere senza lasciare indietro le installazioni più vecchie.


- Un lettore importa un bundle quando
manifest.minReadernon supera la sua versione di lettore. Rifiuta, con "needs a newer version of the app", solo quando il bundle richiede un lettore più recente. - Una modifica additiva, come una nuova parte facoltativa o un nuovo campo facoltativo del manifest, incrementa
formatVersione lascia stareminReader. Le app più vecchie importano comunque ogni parte che riconoscono, e le parti che non riconoscono vengono segnalate come saltate, non scartate in silenzio. - Una modifica incompatibile, in cui l'importazione errata di una parte corrompe i dati o una parte facoltativa diventa obbligatoria, alza
minReader. Le app più vecchie rifiutano allora in modo netto invece di importare qualcosa che non sanno gestire. - Se un bundle futuro imposta
formatVersionma ometteminReader, i lettori ripiegano sul controllo diformatVersione trattano la modifica come incompatibile.
Regola pratica per gli autori: se ogni lettore esistente farebbe comunque la cosa giusta ignorando la tua aggiunta, la modifica è additiva: incrementa
formatVersione lasciaminReader. Altrimenti alzaminReader.
Integrità
Quando manifest.integrity è presente, un lettore controlla lo SHA-256 di ogni parte elencata prima di scrivere qualsiasi cosa. Una discrepanza ("failed its integrity check") o una parte mancante ("incomplete") ferma l'intera importazione, quindi non esiste un ripristino parziale. Questo intercetta il danno che un trasporto di file può causare: un AirDrop troncato, un gateway email che ha ricodificato l'allegato, un settore USB difettoso.
L'integrità è un controllo al meglio possibile. Viene scritta solo dove Web Crypto è disponibile (ogni contesto browser sicuro e Node moderno), e controllata solo quando sono presenti sia la mappa sia Web Crypto. Un bundle senza la mappa, come uno precedente all'esistenza dell'integrità, si importa senza modifiche: "cannot verify" non conta mai come "corrupt".
Il manifest non elenca né sé stesso né il lolly.txt rigenerato. I digest coprono le parti di cui il manifest risponde.
Regole di importazione
Un'importazione viene eseguita in una di due modalità.
- Merge è ciò che fa Import data…, e ciò che fa il primo collegamento di sync, Bring it to this device. I dati sulla destinazione restano, e nulla che non fosse nel bundle viene toccato: una sessione che la destinazione aveva e il bundle no sopravvive all'importazione.
- Replace è ciò che il sync dei dispositivi usa per tenerli allineati: prende il record del profilo, le preferenze, le sessioni, le immagini e la scelta del design system attivo della copia sincronizzata, e rimuove solo gli elementi che un altro dispositivo ha eliminato dall'ultimo sync. Ripristinare una copia precedente va oltre e fa sì che il dispositivo corrisponda a quella copia, rimuovendo tutto ciò che la copia non contiene, dopo aver salvato prima il dispositivo. Sync your devices tratta ciò che vede una persona.
In un merge, tutto ciò che è solo sulla destinazione viene mantenuto, e ogni tipo di dato nel bundle incontra la destinazione così:
| Dati | Già sulla destinazione | Solo nel bundle |
|---|---|---|
| Sessioni (per slot) e immagini caricate (per id) | Viene mantenuta la copia salvata più di recente, quindi un backup più vecchio non sovrascrive mai il lavoro più recente. Orari uguali o sconosciuti mantengono la copia della destinazione. | Aggiunti |
| Cartelle | Il nome e il genitore della destinazione vengono mantenuti, e la cartella acquisisce i membri del bundle che le mancano. Una sessione archiviata in una cartella sulla destinazione resta archiviata lì. | Aggiunte |
| Preferiti (strumenti, risorse del catalogo ed elementi di Projects) | Combinati | Aggiunti |
| Template, template di Projects e strumenti dell'utente (per id) | Viene mantenuto il record della destinazione. | Aggiunti |
| Voci del Cestino | Viene mantenuta la voce della destinazione. | Aggiunte, così un elemento che poteva essere ripristinato su una delle due installazioni può ancora esserlo. Una voce la cui cartella è tornata in uso sulla destinazione, o il cui slot del Cestino la destinazione usa già, viene omessa. |
| Altri campi del profilo (nome, dati di contatto, lingua, feature flag, strumenti nascosti e altre impostazioni) | Viene mantenuto il valore della destinazione. | Presi dove il campo della destinazione è vuoto |
Preferenze (prefs.json) | Viene mantenuto il valore della destinazione. | Scritte dove la destinazione non ne ha |
| Design system (per id) | Il record del bundle sostituisce quello della destinazione. | Aggiunti. La scelta attiva del bundle si applica solo quando la destinazione non ha un design system proprio. |
| Cronologia delle creazioni | La copia salvata più di recente resta corrente, e l'altra viene mantenuta come bozza protetta. | Aggiunta |
Le sessioni salvate si ricollegano automaticamente alle loro immagini. I riferimenti alle risorse sono mantenuti per id, e il bridge li risolve di nuovo dopo il ripristino delle immagini, cosa che deve comunque fare perché gli URL blob: non sopravvivono a un ricaricamento.
I record della cronologia non cambiano mai dopo essere stati scritti. Una nuova importazione di versioni di risorse e ID di operazioni non aggiunge nulla, e un ID che nomina già byte o una cronologia diversi viene rifiutato, non sovrascritto. Reimportare una risorsa corrente identica ne mantiene la versione, e una risorsa corrente modificata deve portare una versione diversa.
La cronologia delle creazioni ha qualche regola in più. Una creazione il cui slot la destinazione usa per un'altra creazione viene aggiunta come creazione separata, e una creazione nel Cestino della destinazione vi resta. Un id di checkpoint che nomina contenuto diverso sulla destinazione mantiene quello della destinazione. Un archivio che non supera i propri controlli ferma l'importazione prima che cambi qualsiasi profilo, sessione, risorsa o preferenza, e una nuova importazione identica non aggiunge archiviazione.
Il riepilogo riporta cosa è successo. Ogni importazione restituisce profile, sessions, userAssets, prefs, skipped e failedAssets.
failedAssetsconta le risorse caricate che non è stato possibile ripristinare, per esempio perché l'archiviazione del dispositivo è piena.skippedconta le parti di un writer più recente che questa build non ha riconosciuto. L'app lo mostra ("… · N newer items skipped"), così un ripristino dichiara ciò che ha lasciato indietro.- Con la cronologia dei file, il riepilogo aggiunge
assetVersions,fileOperations,fileBatchesefailedHistory. L'esaurimento dell'archiviazione o un conflitto di ID immutabile può causare un ripristino parziale, e l'app dice allora alla persona di conservare il backup sorgente. - Con la cronologia delle creazioni, aggiunge
revisionserecoveryDrafts, che contano solo ciò che questa importazione ha aggiunto, eadded,kept,replaced,copiesehiddenper come ogni creazione è stata unita.skippedCheckpointsconta i checkpoint il cui id nomina contenuto diverso sulla destinazione, ehistoryLeftOutconta i checkpoint e le bozze più vecchi che non entravano nello spazio di cronologia del dispositivo. - Un'importazione replace aggiunge
removedefailedRemovals.
Il ripristino non è un'unica transazione attraverso gli archivi di profilo, sessioni, risorse e cronologia. Il sync cloud non fa avanzare la sua revisione applicata dopo un ripristino parziale o non supportato, quindi la copia resta disponibile per riprovare.
Cosa non viaggia
- Cache del catalogo (metadati e blob delle risorse scaricati, l'indice degli strumenti), che la destinazione risincronizza gratis.
- Strumenti e risorse del catalogo, che sono fuori ambito e si presumono presenti sulla destinazione. I token del brand, i font e i loghi aggiunti dall'utente sono risorse dell'utente, quindi viaggiano.
- URL
blob:e di oggetto, che il bridge rigenera al caricamento. - Originali di conversione, lease di esecuzione attivi e segreti di accesso o firma locali alla macchina. Non sono cronologia portabile. Un risultato salvato è una copia, non una promessa che la sorgente originale sia stata salvata nel backup.
- Il contatore di sequenza delle esportazioni, il contatore giornaliero per i nomi dei download in
localStorage(lolly-export-seq). È tenuto fuori daPREF_KEYS, quindi non viaggia mai in un bundle.
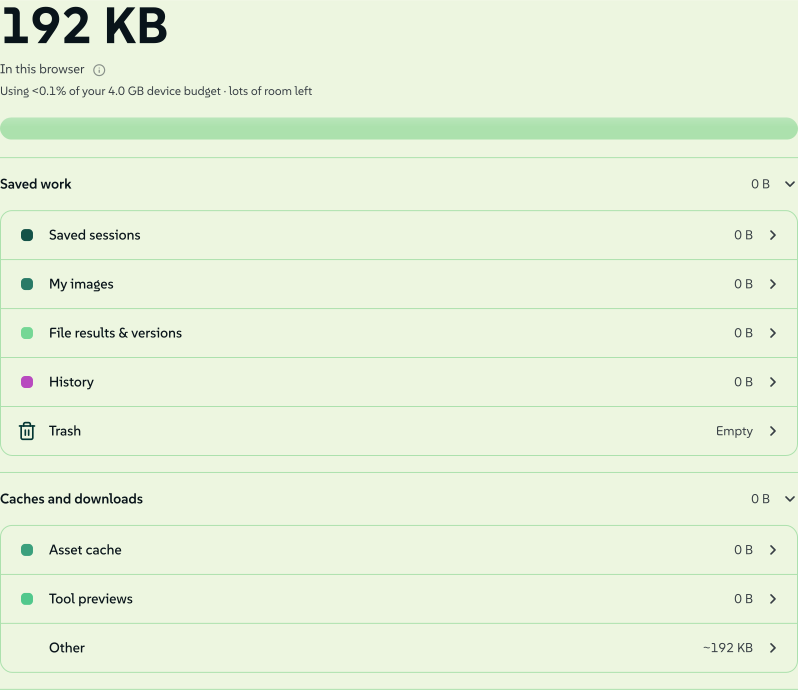
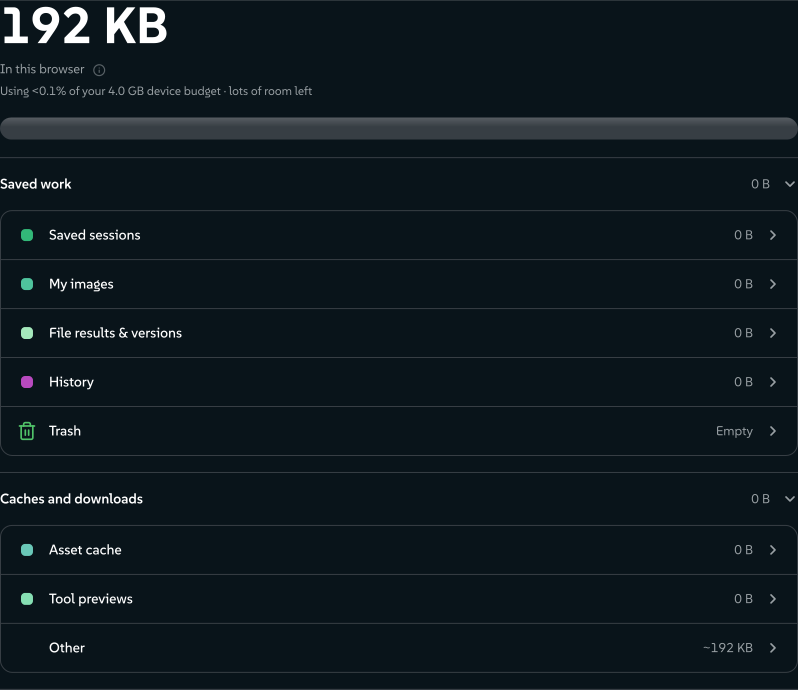
Il misuratore dell'archiviazione mostra la stessa suddivisione. Saved sessions, My images e File results & versions vanno in un bundle. La cache delle risorse, le anteprime degli strumenti e gli elementi fissati per l'uso offline sotto di esse si possono ricostruire, quindi restano indietro.
 signed by Lollyvector SVG37 paths~4.9k nodes85 groups65 KBCheck it yourselfScarica il file firmato
 signed by Lollyvector SVG37 paths~4.9k nodes85 groups65 KBCheck it yourselfScarica il file firmato


Dati dell'organizzazione con Lolly Work
Questo bundle esegue il backup della libreria personale del dispositivo. Non è un backup di un'istanza Lolly Work: account dell'organizzazione, policy di accesso, progetti condivisi, versioni del catalogo, approvazioni, lavori di rendering e record di audit sono conservati da quel servizio. Ricollegati e accedi per riottenere l'accesso al lavoro condiviso; importare un bundle personale non concede quell'accesso.
Gli operatori eseguono backup, conservazione e cancellazione dei dati del server con le guide di Lolly Work: Backup and restore e Work storage and data lifecycle. Cancellare o esportare un dispositivo non esegue nessuna di quelle operazioni sul server.
Tra le shell
data-transfer.ts legge e scrive solo attraverso il bridge di capacità (host.profile, host.state, host.assets) e le preferenze localStorage condivise. Lo stesso modulo legge e scrive l'envelope comune sul web e nelle app desktop e mobile, su archiviazione IndexedDB o filesystem. Le parti facoltative della cronologia compaiono solo dove è disponibile il loro adattatore, e una parte non supportata viene segnalata come saltata all'importazione. La suite headless esercita le parti comuni su un bridge in memoria, e le transazioni della cronologia hanno anche test su browser reale.
Due shell restano fuori da questa garanzia, per motivi diversi:
- La CLI one-shot non ha nulla da trasportare: il suo stato è in memoria e dura una sola invocazione.
- La TUI conserva lo stato in
~/.lolly(sessioni, cartelle, profilo), e la sua vista Profile può eseguirne il backup, ma scrive un archivio più semplice tutto suo:saved-state/<slot>.jsonper sessione piùprofile.jsonefolders.json, senza manifest, senzaformatVersionnéminReadere senza mappa di integrità. Questo formato non può importarlo (un lettore lo rifiuta come "not a Lolly backup"), e il suo nome è confusamente simile (lolly-backup-<stamp>.zip). Unificare i due è una lacuna nota.
Non ancora portabile
L'envelope è un manifest più parti con nome, quindi nuovi tipi di dati portabili possono aggiungersi in seguito come parti additive (un nuovo formatVersion, lo stesso minReader), e i lettori di oggi saltano ciò che non riconoscono. I design system viaggiano già così, come design-systems.json più le loro risorse dell'utente.
Due nomi sono riservati a dati che non viaggiano ancora:
tokens.jsonporterebbe un intero documento di design token W3C DTCG con i suoi gruppi, set e temi, il formato che Penpot importa ed esporta. I token del brand di un utente viaggiano già come risorsauser/tokens/brandinassets.json, e i token di un design system viaggiano con il suo record.penpot/è riservato a un file Penpot acquisito, o al suo sottoinsieme rilevante per Lolly, presentato come strumento.
I lettori di oggi non conoscono ancora nessuno dei due nomi. Come qualsiasi altra cosa fuori dalle parti sopra, ciascuno è per loro una parte sconosciuta: lasciata intatta e conteggiata in skipped.
Parti della cronologia
Le due parti della cronologia sono facoltative e hanno versioni proprie. La maggior parte dei lettori può saltare questa sezione.
Cronologia delle creazioni (v3)
I backup manuali da un'installazione web con cronologia delle creazioni includono revision-history.json, con uno schema proprio { version: 1, documents, revisions, recoveries }. Porta gli ID conservati, le istantanee canoniche degli input, i timbri di versione, le anteprime raster e le bozze separate del writer. L'adattatore della cronologia cattura le sessioni correnti e le loro teste in un'unica transazione di lettura, e sessions.json usa le stesse istantanee correnti per i lettori più vecchi.
Il ripristino controlla lo SHA-256 del payload e il conteggio dei byte, le identità uniche, le relazioni tra documenti e teste, la discendenza, i timestamp, i tipi di anteprima e i limiti prima di confermare l'archivio in un'unica transazione. I riferimenti ai genitori compattati possono mancare. Il lavoro corrente esistente non viene mai sostituito in silenzio: quando una creazione è presente da entrambi i lati, il lato non mantenuto come corrente diventa una bozza protetta.
Il limite di trasferimento di 384 MiB dell'archivio viene controllato esplicitamente, e i limiti di archiviazione sono applicati senza troncare i checkpoint conservati. L'esportazione scrive revision-history.json e sessions.json a blocchi, con gli stessi byte che dà un singolo JSON.stringify, quindi il testo del file non viene mai tenuto per intero. Un file di cronologia che supererebbe il limite viene scartato nel momento in cui lo supera e da lì viene solo contato. L'archivio viene quindi rifatto senza i suoi checkpoint automatici più vecchi, e il riepilogo dell'esportazione li conta come checkpointsLeftOut, oppure l'archivio viene rifiutato per intero.
Una shell senza questa capacità ripristina le sessioni ordinarie e segnala la parte della cronologia come saltata. La cronologia nativa su filesystem resta non supportata finché il suo adattatore non fornisce transazioni durevoli di cronologia. Gli ospiti di una collab privata non hanno cronologia durevole né archivio di ripristino.
Il sync personale delle istantanee lascia fuori la cronologia delle creazioni. Applicare un'istantanea a un documento locale con cronologia mantiene il suo precedente stato di lavoro come bozza di ripristino separata e invalida il token di scrittura di qualsiasi editor aperto. I suoi checkpoint immutabili restano sul dispositivo. Questo protegge la cronologia locale durante la sostituzione di un'istantanea; non unisce le cronologie concorrenti dei dispositivi.
I riferimenti storici alle risorse vengono mantenuti, mentre il rendering risolve ancora le risorse attraverso la libreria esistente della destinazione. Questo archivio non garantisce ancora i byte esatti delle vecchie risorse né i vecchi rendering degli strumenti. I byte delle versioni delle risorse e dei risultati dei file viaggiano nella loro parte di backup.
Versioni salvate e risultati dei file (v2)
La parte facoltativa della cronologia contiene { version: 2, assetVersions: [...], operations: [...], batches: [...] }, e i lettori accettano anche la forma precedente history-v1 senza batch. Ogni istantanea dà l'ID stabile della risorsa e la versione esatta, il suo momento di salvataggio, la lunghezza in byte e lo SHA-256 esadecimale, più un record della risorsa i cui _file e _credentialFile facoltativo puntano a parti binarie. Le operazioni portano i fatti del file originale, la richiesta, il report, i timestamp e un _file di risultato facoltativo. I nomi dei backend di archiviazione, gli handle OPFS e i lease di esecuzione non viaggiano. I lettori che conoscono solo history v1 rifiutano la nuova versione della cronologia prima di importare, anziché scartare in silenzio l'appartenenza ai batch.
I manifest dei batch registrano ogni sorgente selezionata prima dell'elaborazione, compresi i file mai letti, i membri annullati, i fallimenti nel riservare spazio per i risultati e il lavoro interrotto. Ogni membro ha un ID di operazione stabile, un riferimento alla sorgente e i fatti, il nome di output richiesto e il report finale. Una sorgente non letta ha fatti dichiarati, non un digest inventato. L'importazione convalida l'identità dei membri e la coerenza con qualsiasi report di operazione trasportato. I report dei batch restano disponibili quando i singoli risultati sono stati rimossi, ma una ricevuta non significa che i byte del suo output siano ancora conservati.
- Prima la convalida. Ogni record di cronologia, report e file referenziato noto viene convalidato prima che qualsiasi importazione di profilo o risorsa scriva. Byte mancanti e SHA-256 non corrispondenti falliscono anche quando l'envelope non ha una mappa di integrità. Le credenziali estratte restano array di byte, comprese le importazioni da writer più vecchi che le serializzavano come oggetti con chiavi numeriche.
- Lavoro in corso. Le operazioni in corso diventano record interrotti nel backup, con un report di errore esplicativo e nessun risultato. Il ripristino non riavvia mai il lavoro in background né importa un lease attivo. Riprovare significa selezionare di nuovo il file originale, verificato rispetto al suo SHA-256 registrato quando disponibile.
- Archiviazione. I risultati ripristinati confermano insieme byte e metadati in IndexedDB. I nuovi risultati ordinari usano OPFS dove disponibile, con ripiego su IndexedDB. Un'operazione attiva esistente non viene mai sostituita da un'importazione.
- Limiti del backup. L'esportazione scrive questi byte nell'archivio in streaming, ma il ripristino decomprime ancora un intero backup in memoria, quindi i limiti restano: 256 MiB di payload di cronologia, 4 MiB di metadati di cronologia, al massimo 100 operazioni, 100 batch e 2.000 istantanee. L'esportazione rifiuta esplicitamente una cronologia troppo grande o incompleta e non la omette mai in silenzio. Scarica una per una le versioni e i risultati importanti prima di rimuovere le copie locali più vecchie. Questi limiti non sono una garanzia misurata sul picco di memoria per i telefoni.
- Budget locali. La cronologia locale dei risultati ha un budget di 512 MiB e un tetto di 100 record. Le istantanee delle risorse hanno un budget separato di 512 MiB e al massimo 20 versioni storiche per risorsa, e i byte delle credenziali estratte contano per quel budget. Il ripristino rispetta questi limiti e non espelle mai in silenzio i dati esistenti dell'utente.
- Metadati dei batch. I metadati locali dei batch hanno un budget separato di 4 MiB, al massimo 100 manifest e 20 membri per batch. I membri in sospeso riservano capacità di metadati, con un tetto di report di 32 KiB per membro. È un budget logico, non una garanzia di spazio su disco del browser: un vero errore di quota viene mostrato, e il report in memoria resta scaricabile. Riprovare un membro di un batch crea un nuovo batch senza sovrascrivere il vecchio report. Rimuovere un record di batch non rimuove i singoli byte dei risultati né le risorse della libreria.
- Risultati nella libreria. I risultati convertiti possono essere aggiunti alla libreria senza normalizzazione né ricodifica, con gli hash di sorgente e output e la relazione dell'operazione allegati. Aggiunte ripetute riutilizzano una copia invariata, e una copia modificata non viene mai sovrascritta. Le immagini raster possono avviare un nuovo documento Design, che usa l'ID della risorsa corrente della libreria; far rispettare le versioni esatte fissate in tutto il runtime di Design e nel percorso URL è un lavoro separato. I risultati SVG, HTML, PDF e ZIP sono conservati come risorse file opache, non promossi a contenuto interattivo o vettoriale attendibile.
- Dove le persone lo vedono. Convert → Recent file operations mostra l'uso della cronologia, i report, i download e il gestore delle versioni, che trova anche versioni precedenti di risorse eliminate dalla libreria. Ripristinare un'istantanea crea una nuova versione corrente e mantiene l'istantanea selezionata. Settings → Preferences → Storage conta risultati e versioni separatamente dalle cache eliminabili.
- Pulizia. La pulizia esplicita dei file temporanei rimuove solo i byte posseduti dall'operazione e non referenziati. I record correnti proteggono i loro file, e i file OPFS recenti hanno un periodo di tolleranza di un'ora. I risultati salvati e le istantanee delle risorse non vengono cancellati automaticamente.
I lettori più vecchi accettano comunque l'envelope v2 (minReader: 1) e ripristinano le parti che conoscono, contando le parti di cronologia non supportate come saltate. Il pieno recupero della cronologia richiede una shell con l'adattatore fileHistory, una giuntura dentro la shell e non una nuova capacità HostV1 rivolta agli strumenti. Il vero ripristino su due dispositivi è coperto dal gate Chromium locale; il recupero sulle app desktop, iOS e Android installate deve ancora essere accettato separatamente.
Riferimento
- Modulo:
shells/web/src/data-transfer.ts(exportBackup,importBackup,BACKUP_FORMAT,BACKUP_FORMAT_VERSION,BACKUP_READER_VERSION; il generatore di nomibackupFilename()è interno). - Test di contratto:
tests/data-transfer.test.ts, che copre round trip, merge, integrità, compatibilità in avanti e il controllo del lettore. - Test di contratto della cronologia:
tests/file-history-backup.test.ts,tests/file-batch-history.test.tsetests/file-result-library.test.ts. Accettazione su browser:tests/file-history.browser.test.ts,tests/file-batch-history.browser.test.tsetests/file-result-reuse.browser.test.ts. - Superficie del bridge usata:
host.profile,host.stateehost.assets; vedi Host API.