
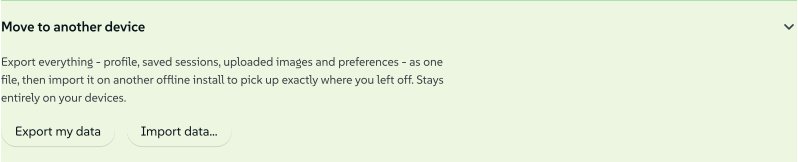
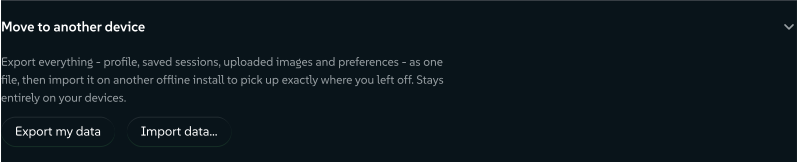
Todo lo que acumula un usuario de Lolly vive en su dispositivo - sin cuenta, sin nube. El paquete de transferencia de datos es cómo se mueve ese valor: expórtalo en una instalación, lleva el archivo por cualquier medio (USB, AirDrop, correo a ti mismo, una carpeta compartida en red) e impórtalo en otra. El archivo es el transporte. El destino puede estar sin conexión o con conexión. No importa, porque nada habla nunca con un servidor.
 signed by Lollyvector SVG9 paths~4.9k nodes11 groups56 KBCompruébalo tú mismoDescarga el archivo firmado
 signed by Lollyvector SVG9 paths~4.9k nodes11 groups56 KBCompruébalo tú mismoDescarga el archivo firmado


Esta página es la especificación del formato. Para el recorrido pensado para el usuario final, consulta Encuentra y recupera tu trabajo → Pasa tu trabajo a otro dispositivo. La implementación es shells/web/src/data-transfer.ts, y tests/data-transfer.test.ts fija el contrato de ida y vuelta.
Alcance. Un paquete lleva datos del usuario, no herramientas del catálogo. Las herramientas y los recursos del catálogo se sincronizan por separado y se asume que ya están presentes en el destino (en el peor caso, en una versión más nueva); las herramientas que el propio usuario creó viajan dentro de
profile.json. Importar nunca instala ni actualiza una herramienta del catálogo.
Objetivos
- Un formato, todos los shells. La PWA web, las apps de escritorio/móvil de Tauri y los shells futuros comparten el mismo sobre y los mismos esquemas de partes admitidas. Las partes opcionales dependen de las capacidades de cada shell; las partes no admitidas se reportan. Cada puente de capacidades aporta su propio adaptador de almacenamiento.
- Sobrevive al trayecto. Un paquete dañado o truncado en tránsito falla de forma clara al importar, nunca restaura a medias.
- Sobrevive a esta versión. Una app más antigua puede seguir importando las partes reconocidas de un paquete más nuevo. Un formato genuinamente incompatible se rechaza limpiamente.
- Seguro para fusionar. Importar sobre una instalación ya en uso nunca borra nada que no estuviera en el paquete.
El sobre
Un paquete es un simple .zip. La descarga se nombra según la persona a la que pertenece - LollyTools-<First>-<Last>-<YYYY-MM-DD>-<n>.zip (por ejemplo, LollyTools-Ada-Lovelace-2026-06-26-1.zip) - para que una carpeta de Descargas llena de copias de seguridad siga siendo legible. Las partes de nombre y apellido provienen del perfil y se omiten cuando no están definidas. Sin perfil se obtiene LollyTools-2026-06-26-1.zip, y solo con un nombre de pila se obtiene LollyTools-Ada-2026-06-26-1.zip. Cada parte se sanea a un token seguro para nombres de archivo (se conservan letras/dígitos Unicode, se eliminan espacios/puntuación, con un tope de 32 caracteres). <n> es una secuencia por día y por dispositivo, de modo que las exportaciones repetidas el mismo día no chocan entre sí y se mantienen en orden. backupFilename() en shells/web/src/data-transfer.ts construye el nombre. El contenido del zip es idéntico sin importar el nombre. Dentro:
| Path | Obligatorio | Contenido |
|---|---|---|
manifest.json | sí | Id de formato, versiones, recuentos e integridad por parte. Lo primero que mira un lector. |
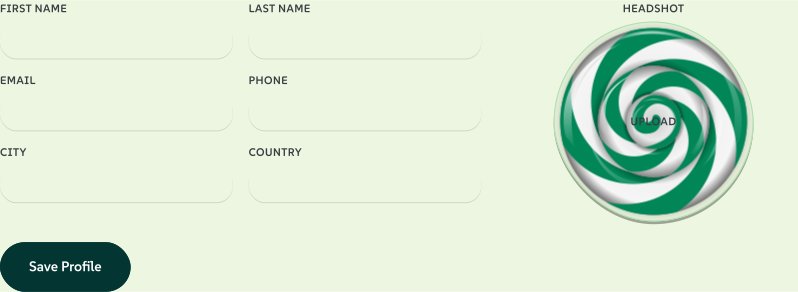
profile.json | si está definido | Todo el registro me del usuario: nombre, contacto, referencia de foto e indicadores, más carpetas, Papelera, plantillas de proyecto, plantillas de usuario y herramientas creadas por el usuario, favoritos, herramientas ocultas, idioma y elección de emoji. Se lee mediante host.profile. |
sessions.json | sí | Cada sesión guardada: slot, id/versión de herramienta, etiqueta, miniatura (data-URL) y datos de entrada completos. Se lee mediante host.state. |
assets.json | sí | Metadatos de cada recurso subido (imágenes, fuentes, tokens de marca, logotipos, copias guardadas de descargas), cada uno apuntando a sus bytes bajo assets/blobs/. |
assets/blobs/<n>.<ext> | por recurso | Los bytes en bruto del recurso (archivos de imagen y de fuente). Almacenados sin comprimir (formatos ya comprimidos). La extensión es cosmética. El MIME en assets.json es el que manda. |
assets/blobs/<n>.c2pa | cuando está presente | Content Credentials extraídas como bytes binarios exactos, referenciadas por _credentialFile en el registro del recurso. No son claves de firma del dispositivo. |
design-systems.json | cuando está presente | Los sistemas de diseño creados o añadidos en esta instalación, como { active, records }. Se fusionan por id al importar; la elección activa del paquete se aplica solo cuando el destino no tiene un sistema de diseño propio. |
file-history.json | opcional | Instantáneas de recursos con versión, informes finales de operación de archivo y manifiestos de lote completos. La parte de historial tiene su propia versión; la proporciona el adaptador interno de copia de seguridad fileHistory del shell. |
revision-history.json | opcional, copias de seguridad manuales | Ids de creación estables, puntos de control retenidos, miniaturas y borradores de recuperación continuos. Lo proporciona host.state.history.backup donde se admite. |
file-history/versions/ | por instantánea | Bytes de recurso anteriores y credenciales extraídas, independientemente de si el recurso actual todavía existe. |
file-history/results/ | por operación completada | Bytes de salida exactos. No se conserva ni se incluye ningún archivo original seleccionado para conversión. |
prefs.json | sí | Preferencias locales del usuario: theme, sidebarWidth y el recuento de actividad ct-metrics. |
lolly.txt | sí | Un resumen legible del paquete (recuentos, perfil, nombre de archivo) para quien abra el zip sin Lolly. Se regenera en cada exportación y se reconoce al importar, así que nunca cuenta como parte omitida. Se escribe después del mapa de integridad, así que queda fuera de él. |
El paquete es un zip normal a propósito: sobrevive intacto a cualquier transporte, y cualquier herramienta de descompresión puede inspeccionarlo.
profile.json es la parte más pequeña y la primera que ve un lector en la app: los datos que un productor rellena una sola vez, más el opt-in que permite que las herramientas los usen.
 signed by Lollyvector SVG15 paths~1.2k nodes30 groups1 image40 KBCompruébalo tú mismoDescarga el archivo firmado

manifest.json
{
  "format": "lolly-backup",
  "formatVersion": 3,
  "minReader": 1,
  "app": "lolly",
  "exportedAt": "2026-06-22T09:30:00.000Z",
  "counts": { "profile": true, "sessions": 2, "userAssets": 4, "prefs": 3, "assetVersions": 1, "fileOperations": 1 },
  "integrity": {
    "profile.json": "sha256-…",
    "sessions.json": "sha256-…",
    "assets.json": "sha256-…",
    "assets/blobs/0.bin": "sha256-…",
    "file-history.json": "sha256-…",
    "file-history/versions/0.bin": "sha256-…",
    "file-history/results/0.bin": "sha256-…",
    "prefs.json": "sha256-…"
  }
}| Campo | Significado |
|---|---|
format | Siempre lolly-backup. Un archivo sin él se rechaza como "no es una copia de seguridad de Lolly". |
formatVersion | La versión con la que se escribió este paquete. Se incrementa con cualquier cambio en el conjunto o la forma de las partes. Los lectores no se rigen por ella. |
minReader | La versión mínima de lector necesaria para importar este paquete con seguridad. Este es el campo que rige a los lectores. |
app | Id de la app productora, para diagnóstico. |
exportedAt | Marca de tiempo ISO en la que se creó el paquete. |
counts | Lo que puso el escritor, para mostrar y para comprobaciones de coherencia. |
integrity | Opcional. Asocia cada parte excepto manifest.json con un resumen estilo SRI sha256-<base64> de sus bytes sin comprimir. |
Política de versiones (compatibilidad hacia adelante)
La división entre formatVersion y minReader es lo que permite que el formato crezca sin dejar huérfanas a las instalaciones más antiguas:
- Un lector importa un paquete cuando
manifest.minReader ≤su propia versión de lector. Se niega (con "necesita una versión más nueva de la app") solo cuando el paquete exige explícitamente un lector más nuevo. - Un cambio aditivo - una nueva parte opcional, o un nuevo campo opcional del manifiesto - incrementa
formatVersionpero dejaminReadersin cambios. Las apps más antiguas siguen importando todas las partes que reconocen. Las partes que no reconocen se omiten (ver más abajo), no se descartan en silencio. - Un cambio incompatible - uno en el que importar mal una parte corrompe datos, o en el que una parte antes opcional pasa a ser obligatoria - eleva
minReader. Las apps más antiguas entonces se niegan limpiamente en lugar de importar algo que no pueden manejar. - Si un paquete futuro define
formatVersionpero omiteminReader, los lectores, por precaución, se rigen porformatVersion(tratan el cambio como incompatible).
Regla práctica para autores: si todo lector existente seguiría haciendo lo correcto al ignorar tu adición, es aditivo - incrementa
formatVersion, dejaminReaderigual. En caso contrario, elevaminReader.
Integridad
Cuando manifest.integrity está presente, un lector verifica el SHA-256 de cada parte listada antes de escribir nada. Una discordancia ("falló su comprobación de integridad") o una parte faltante ("incompleto") aborta toda la importación - no hay restauración parcial. Esto detecta la corrupción que puede introducir un transporte de archivos (un AirDrop truncado, una pasarela de correo que recodificó el adjunto, un sector USB defectuoso).
La integridad es de mejor esfuerzo por diseño: solo se escribe donde Web Crypto está disponible (todo contexto seguro de navegador y Node moderno), y solo se verifica cuando el mapa y Web Crypto están presentes a la vez. Un paquete sin el mapa - por ejemplo uno de antes de que existiera la integridad - se importa sin cambios. "No se puede verificar" nunca se trata como "corrupto".
El manifiesto no se lista a sí mismo ni al README lolly.txt regenerado. Los resúmenes cubren las partes que el manifiesto avala.
Semántica de importación
Importar es una fusión, nunca un reemplazo total:
- Los datos existentes en el destino se dejan en su sitio.
- Cuando un slot de sesión o un id de imagen subida existe en ambos, se conserva la copia guardada más recientemente, así que una copia de seguridad más antigua nunca sobrescribe un trabajo más reciente en el destino. Con fechas iguales o desconocidas se conserva la copia del destino. En una instalación web con historial de creaciones, la misma regla decide qué copia de una creación permanece actual, y la otra copia se conserva como borrador protegido (véase más abajo).
- El registro de perfil se fusiona, no se reemplaza. Cada carpeta del destino conserva su contenido; una carpeta del paquete que el destino no tiene se añade, y una carpeta presente en ambos conserva el nombre y el padre del destino y recibe los miembros del paquete que le faltan. Una sesión archivada en una carpeta del destino sigue archivada allí.
- Los favoritos (herramientas, recursos del catálogo y elementos de Proyectos) se combinan. Las plantillas, las plantillas de Proyectos y las herramientas de usuario del paquete se añaden cuando el destino no tiene ningún registro con ese id. Las entradas de Papelera de ambos se conservan, así que un elemento que se podía restaurar en cualquiera de las dos instalaciones se sigue pudiendo restaurar.
- Cualquier otro campo del perfil (nombre, datos de contacto, idioma, feature flags, herramientas ocultas y el resto de ajustes) conserva el valor del destino. Un campo vacío en el destino toma el valor del paquete. Lo mismo ocurre con
prefs.json: una preferencia solo se escribe donde el destino no tiene ninguna. - La aplicación normal de la sincronización de dispositivos es la excepción: para mantener los dispositivos al día, toma el registro de perfil, las preferencias, las sesiones y las imágenes de la copia sincronizada. Restaurar una copia anterior hace lo mismo, ya que retrocede en el tiempo a propósito. La primera incorporación, Traer a este dispositivo, fusiona como una importación.
- Las versiones históricas de recursos y los ids de operación son excepciones inmutables: una importación repetida es idempotente, y un id que ya nombra bytes/historial distintos se rechaza, no se sobrescribe. Reimportar un recurso actual idéntico conserva su versión. Un recurso actual modificado debe llevar una versión distinta.
- El historial de creaciones también se fusiona. Una creación presente en ambos lados conserva la copia guardada más recientemente como actual y la otra copia como borrador protegido; una creación cuyo slot usa el destino para otra creación se añade junto a ella; una creación en la Papelera del destino permanece allí. Un id de checkpoint que nombra un contenido distinto en el destino conserva el del destino. Un archivo que no supera sus propias comprobaciones detiene la importación antes de cualquier cambio de perfil, sesión, recurso o preferencias. Una importación repetida idéntica no añade almacenamiento.
- Nada que no estuviera en el paquete se toca. Una sesión que el destino tenía pero el paquete no sobrevive a la importación.
Las sesiones guardadas se reenlazan automáticamente con sus imágenes: las referencias a recursos se conservan por id, y el puente las vuelve a resolver después de restaurar las imágenes subidas (tiene que hacerlo de todos modos, porque las URLs blob: no sobreviven a una recarga).
El resumen de importación reporta { profile, sessions, userAssets, prefs, skipped, failedAssets }. failedAssets cuenta los recursos subidos que no se pudieron restaurar (almacenamiento del dispositivo lleno, por ejemplo). Es distinto de skipped, que cuenta partes de un escritor más nuevo compatible hacia adelante que esta build no reconoció. La interfaz muestra skipped ("… · N elementos más nuevos omitidos"), para que la restauración sea honesta sobre lo que dejó atrás.
Cuando el historial de archivos está presente, el resumen también lleva assetVersions, fileOperations y failedHistory. El agotamiento del almacenamiento o los conflictos de id inmutable pueden causar una restauración parcial; la interfaz le dice al usuario que conserve la copia de seguridad de origen. La sincronización en la nube no avanza su revisión aplicada tras una restauración parcial o no admitida, así que la instantánea sigue disponible para reintentarlo. La restauración no es una única transacción a través de todos los almacenes de perfil, sesión, recurso e historial.
Historial de creaciones (v3)
Las copias de seguridad manuales desde un host web con capacidad de historial incluyen revision-history.json con su propio esquema { version: 1, documents, revisions, recoveries }. Lleva los ids retenidos, las instantáneas canónicas de entrada, las marcas de versión, las vistas previas ráster y borradores de escritor independientes. El adaptador de historial captura las sesiones actuales y sus cabezas en una sola transacción de lectura; sessions.json usa esas mismas instantáneas actuales para lectores más antiguos.
La restauración comprueba el SHA-256 y el recuento de bytes de la carga útil, las identidades únicas, las relaciones documento/cabeza, la ascendencia, las marcas de tiempo, los tipos de vista previa y los límites antes de confirmar el archivo en una sola transacción. Las referencias al padre compactadas pueden estar ausentes. El trabajo actual existente nunca se reemplaza en silencio: cuando una creación está en ambos lados, el lado que no se conserva como actual se convierte en un borrador protegido. El límite de transferencia de 384 MiB del archivo se comprueba explícitamente, y los límites de almacenamiento se hacen cumplir sin truncar los puntos de control retenidos. La copia de seguridad global sigue usando una implementación de ZIP en memoria y no es un archivo en streaming.
El resumen añade revisions y recoveryDrafts, que solo cuentan lo que esta importación añadió, y added, kept, replaced, copies y hidden para indicar cómo se fusionó cada creación. Un shell sin esta capacidad restaura las sesiones normales y reporta la parte de historial como omitida. El historial del sistema de archivos nativo sigue sin admitirse hasta que su adaptador aporte transacciones de historial duraderas. El estado de invitado P2P no tiene historial duradero ni archivo de recuperación.
La sincronización de instantáneas personales excluye explícitamente el historial de creaciones. Aplicar una instantánea a un documento local que lleva historial conserva su estado de trabajo anterior como un borrador de recuperación aparte e invalida el token de escritura de cualquier editor abierto. Sus puntos de control inmutables permanecen en el dispositivo. Esto protege el historial local durante la sustitución de la instantánea; no fusiona los historiales concurrentes de varios dispositivos.
Las referencias históricas a recursos se conservan, mientras que el renderizado sigue resolviendo los recursos a través de la biblioteca existente del destino. Este archivo todavía no garantiza los bytes exactos de recursos antiguos ni los renderizados antiguos de herramientas. Los bytes de versión de recurso y de resultado de archivo siguen viajando a través de su parte de copia de seguridad separada existente.
Versiones guardadas y resultados de archivo (v2)
La parte opcional de historial contiene { version: 2, assetVersions: [...], operations: [...], batches: [...] }; los lectores también aceptan la forma anterior de historial-v1 sin batches. Cada instantánea identifica el id de recurso estable y la versión exacta, su hora de guardado, la longitud en bytes y el SHA-256 hexadecimal, más un registro de recurso cuyo _file y opcional _credentialFile apuntan a partes binarias. Las operaciones llevan los datos originales del archivo, la solicitud, el informe, las marcas de tiempo y un _file de resultado opcional; los nombres de backend de almacenamiento, los identificadores OPFS y los arrendamientos de ejecución no viajan. Los lectores antiguos que solo admiten historial-v1 rechazan la nueva versión de historial antes de importar, en lugar de descartar en silencio la pertenencia a un lote.
Los manifiestos de lote registran cada fuente seleccionada antes del procesamiento, incluidos los archivos nunca leídos, los miembros cancelados, los fallos al reservar espacio de resultado y el trabajo interrumpido. Cada miembro tiene un id de operación estable, una referencia/datos de fuente, un nombre de salida solicitado y un informe final. Una fuente no leída tiene datos declarados, no un resumen inventado. La importación valida la identidad del miembro y su coherencia con cualquier informe de operación llevado consigo. Los informes de lote siguen disponibles cuando los resultados individuales se han eliminado explícitamente, pero un recibo no implica que sus bytes de salida sigan almacenados.
- Todo registro de historial, informe y archivo referenciado conocido se valida antes de cualquier escritura de importación de perfil o recurso. Los bytes faltantes y los SHA-256 no coincidentes fallan incluso si el sobre no tiene mapa de integridad. Las credenciales extraídas siguen siendo arrays de bytes, incluidas las importaciones de escritores más antiguos que las serializaron en JSON como objetos de clave numérica.
- Las operaciones en curso se convierten en registros interrumpidos en la copia de seguridad, con un informe de fallo explicativo y sin resultado. Restaurar nunca reinicia trabajo en segundo plano ni importa un arrendamiento activo. Reintentar exige seleccionar el archivo original, comprobado contra su SHA-256 registrado cuando está disponible.
- Los resultados restaurados confirman sus bytes y metadatos juntos en IndexedDB. Los resultados nuevos normales usan OPFS donde está disponible, con una alternativa en IndexedDB. Una operación en curso existente nunca se reemplaza por una importación.
- El ensamblaje del ZIP de historial sigue siendo en memoria: el límite actual es 256 MiB de carga útil de historial, 4 MiB de metadatos de historial, como máximo 100 operaciones, 100 lotes y 2000 instantáneas. La exportación rechaza explícitamente un historial demasiado grande o incompleto; nunca lo omite en silencio. Descarga individualmente las versiones/resultados importantes antes de eliminar copias locales más antiguas. Estos límites no son una garantía medida de pico de memoria para teléfonos.
- El historial de resultados local tiene un presupuesto de 512 MiB y un tope de 100 registros. Las instantáneas de recursos tienen un presupuesto separado de 512 MiB y como máximo 20 versiones históricas por recurso; los bytes de credenciales extraídas cuentan para ese presupuesto de instantáneas. La restauración respeta estos límites y nunca desaloja en silencio datos de usuario existentes.
- Los metadatos de lote locales tienen un presupuesto separado de 4 MiB, como máximo 100 manifiestos y 20 miembros por lote. Los miembros pendientes reservan capacidad de metadatos, con un tope de 32 KiB de informe por miembro. Esto es un presupuesto lógico, no una garantía de espacio en disco del navegador; un fallo de cuota real se muestra y el informe en memoria sigue siendo descargable. Reintentar un miembro de lote crea un lote nuevo sin sobrescribir el informe antiguo. Eliminar un registro de lote no elimina los bytes de resultado individuales ni los recursos de la biblioteca.
- Los resultados convertidos se pueden añadir explícitamente a la biblioteca sin normalización ni recodificación. Los hashes de origen/salida y la relación con la operación acompañan al recurso. Las adiciones repetidas reutilizan una copia sin cambios; una copia editada nunca se sobrescribe. Las imágenes ráster pueden iniciar un nuevo documento de Design. Ese documento usa el id de recurso actual de la biblioteca: hacer cumplir fijaciones de versión exactas en todo el runtime y la ruta de URL de Design sigue siendo trabajo aparte. Los resultados SVG/HTML/PDF/ZIP se conservan como recursos de archivo opacos mediante este traspaso, no se promueven a contenido interactivo/vectorial de confianza.
- Convert → Recent file operations muestra el uso del historial, los informes, las descargas y el gestor de versiones. El gestor también encuentra versiones anteriores de recursos de biblioteca eliminados. Restaurar una instantánea crea una versión actual nueva conservando intacta la instantánea seleccionada. Ajustes → Almacenamiento contabiliza los resultados y las versiones por separado de las cachés desechables.
- La limpieza explícita de archivos temporales solo elimina bytes propios de una operación y sin referenciar. Los registros actuales protegen sus archivos; los archivos OPFS recientes tienen un período de gracia de una hora. Los resultados guardados y las instantáneas de recursos no se limpian automáticamente.
Los lectores más antiguos siguen aceptando el sobre v2 (minReader: 1) y restauran las partes conocidas, contando las partes de historial no admitidas como omitidas. La recuperación completa del historial requiere un shell con el adaptador fileHistory; esto es una costura interna del shell, no una nueva capacidad HostV1 de cara a las herramientas. La restauración real entre dos dispositivos está cubierta por la puerta local de Chromium; la aceptación de recuperación instalada en Tauri/iOS/Android sigue siendo aparte.
Qué no viaja
- Cachés del catálogo (metadatos y blobs de recursos descargados, el índice de herramientas) - se resincronizan gratis en el destino.
- Herramientas y recursos del catálogo - fuera de alcance, y se asume que ya están presentes en el destino. Los tokens de marca, las tipografías y los logotipos que añadió el usuario son recursos de usuario, así que sí viajan.
- URLs
blob:/ de objeto - regeneradas por el puente al cargar. - Los originales de conversión, los arrendamientos de ejecución en vivo y los secretos de acceso/firma locales de la máquina - no son carga útil de historial portable. Un resultado guardado es una copia, no una promesa de que el origen original se respaldó.
- El contador de secuencia de exportación - el contador de nomenclatura de descargas por día (clave de
localStoragelolly-export-seq) es una conveniencia de nomenclatura local. Se mantiene fuera dePREF_KEYS, así que nunca viaja en un paquete.
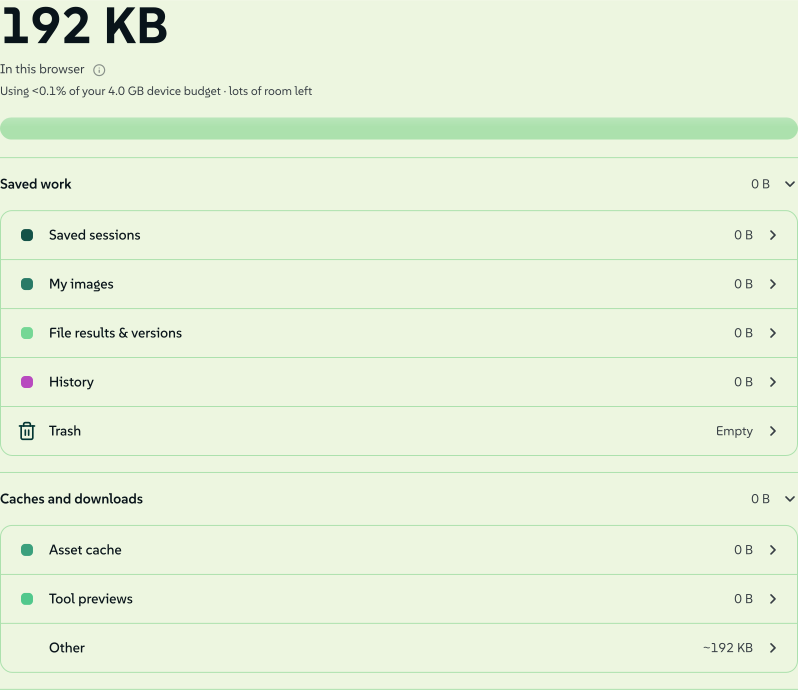
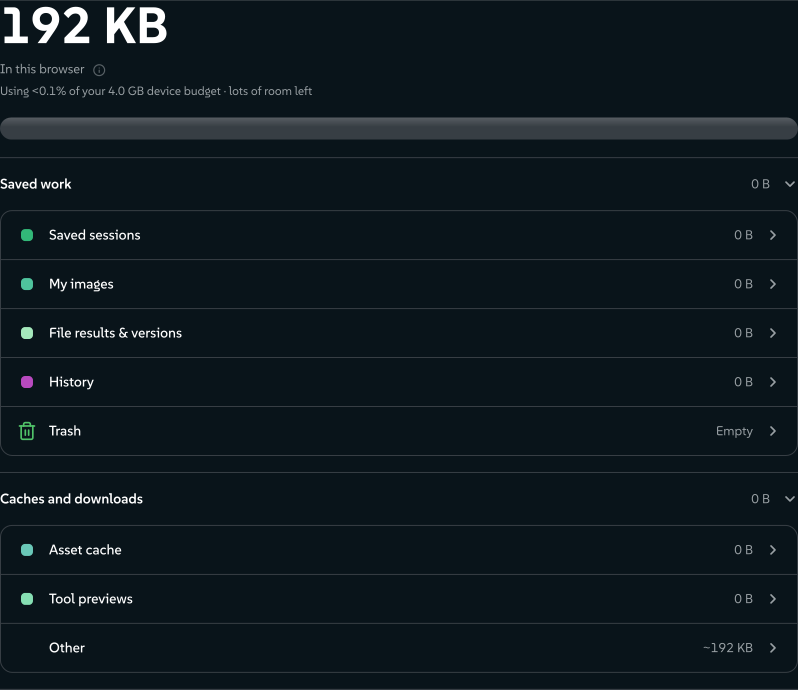
El medidor de almacenamiento desglosa la misma división. Las sesiones guardadas, Mis imágenes y los resultados y versiones de archivo viajan en un paquete. La caché de recursos, las vistas previas de herramientas y los anclajes sin conexión debajo de ellas son todos re-derivables, así que se quedan atrás.
 signed by Lollyvector SVG37 paths~4.9k nodes85 groups65 KBCompruébalo tú mismoDescarga el archivo firmado
 signed by Lollyvector SVG37 paths~4.9k nodes85 groups65 KBCompruébalo tú mismoDescarga el archivo firmado


Garantía entre shells
data-transfer.ts lee y escribe exclusivamente a través del puente de capacidades (host.profile, host.state, host.assets) y las preferencias compartidas de localStorage. El mismo módulo lee y escribe el sobre común en web y en Tauri, sobre IndexedDB o almacenamiento del sistema de archivos. Las partes opcionales de historial aparecen solo donde el adaptador correspondiente está disponible; una parte no admitida se reporta como omitida al importar. La batería de pruebas sin interfaz gráfica ejercita las partes comunes contra un puente en memoria, mientras que las transacciones de historial también tienen pruebas en navegador real.
Dos shells quedan fuera de esa garantía, por razones distintas:
- La CLI de un solo uso no tiene nada que transportar - su estado está en memoria y es efímero por invocación.
- La TUI sí persiste estado (
~/.lolly: sesiones, carpetas, perfil) y su vista de Perfil puede respaldarlo, pero escribe un archivo más simple propio:saved-state/<slot>.jsonpor sesión másprofile.jsonyfolders.json, sin manifiesto, sinformatVersion/minReadery sin mapa de integridad. No se puede importar con este formato - un lector lo rechaza como "no es una copia de seguridad de Lolly" - y, para más confusión, usa un nombre parecido (lolly-backup-<stamp>.zip). Unificar los dos es una carencia conocida.
Puntos de extensión reservados
El sobre es, por diseño, un manifiesto más un conjunto de partes con nombre, para que nuevos tipos de datos portables puedan viajar en él más adelante sin un cambio incompatible. Se incorporan como partes aditivas (nuevo formatVersion, mismo minReader), y el lector actual omite lo que no reconoce. Esto todavía no está implementado. Los nombres se reservan aquí para que el formato siga siendo coherente cuando lleguen.
tokens.json- tokens de diseño. Un documento de tokens de diseño W3C DTCG (el formato que Penpot importa y exporta - tokens con$value/$type/$description, organizados en grupos, conjuntos y temas). Un conjunto de tokens en el paquete permite a un usuario mover los primitivos de su marca entre instalaciones junto con sus sesiones. (Los propios tokens de marca de un usuario ya viajan hoy como el recursouser/tokens/brandenassets.json; esta parte llevaría un documento DTCG completo con sus conjuntos y temas.) A más largo plazo, un conjunto de tokens ingerido se convierte en una fuente de primer nivel contra la que resuelven las herramientas y los recursos de paleta.penpot/- archivos de Penpot ingeridos. Un directorio reservado para un archivo de Penpot (o su subconjunto extraído, relevante para Lolly) importado y expuesto como una herramienta. El paquete llevará la definición ingerida, para que viaje con el resto de los datos del usuario.
Cualquier cosa fuera de estos nombres reservados y de las partes anteriores es, para un lector, una parte desconocida: se deja intacta y se cuenta en skipped.
Referencia
- Módulo:
shells/web/src/data-transfer.ts(exportBackup,importBackup,BACKUP_FORMAT,BACKUP_FORMAT_VERSION,BACKUP_READER_VERSION- el nombradorbackupFilename()es interno). - Prueba de contrato:
tests/data-transfer.test.ts- casos de ida y vuelta, fusión, integridad, compatibilidad hacia adelante y control de lector. - Pruebas de contrato de historial:
tests/file-history-backup.test.ts,tests/file-batch-history.test.tsytests/file-result-library.test.ts. Aceptación en navegador:tests/file-history.browser.test.ts,tests/file-batch-history.browser.test.tsytests/file-result-reuse.browser.test.ts. - Superficie de puente usada:
host.profile,host.state,host.assets- ver Host API.